文本信息检索是针对文本的信息检索技术。在技术社区中,文本信息检索常常被等同于信息检索技术本身。
相对视频、音频检索而言,文本信息检索是发展较快也较成熟的,其他模态的信息检索技术,往往也要仰赖文本信息检索的支持。
虽然网络搜索引擎目前已不仅仅局限于对文本进行检索,文本信息检索仍然是大部分网络搜索引擎的基础。
历史介绍
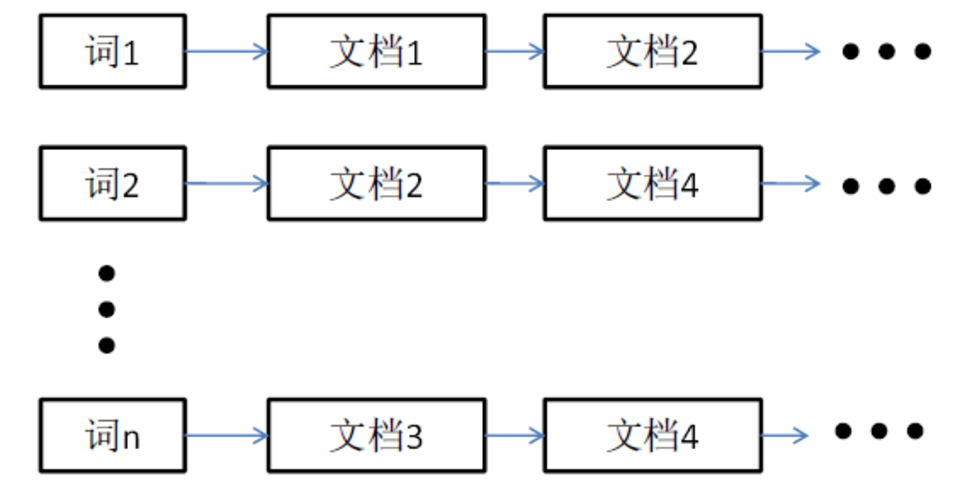
自人类的文字产生起,如何快速地从大量的,记录在各种各样的存储媒体中寻找或获取信息就成为一个引人注目的问题。这个问题关系到人类如何能够主动地获取自己需要的知识。因此,文本信息检索技术甚至可以追述到古代的书籍编目。但是直到近一个世纪,随着人类的知识以前所未有的速度急剧膨胀,信息存储方式越来越丰富,使得在海量的,多模态的信息库中进行快速、准确的检索成为急迫的需求。1945年,Vannevar Bush的论文《就像我们可能会想的……》第一次提出了设计自动的,在大规模的存储数据中进行查找的机器的构想。这被认为是现在信息检索技术的开山之作。进入50年代后,研究者们开始为逐步的实现这些设想而努力。在50年代中期,在利用电脑对文本数据进行检索的研究上,研究者取得了一些成果。其中最有代表性的是Luhn在IBM公司的工作,他提出了利用词对文档构建索引并利用检索与文档中词的匹配程度进行检索
的方法,这种方法就是目前常用的倒排文档技术的雏形。
在60年代,信息检索技术的一些关键技术取得了突破。其间出现了一些优秀的系统以及评价指标。在评价指标方面,由Cranfield的研究组组织的Cranfield评测提出了许多目前仍然被广泛采用的评价指标,而在系统方面,Gernard Salton开发的SMART系统构建了一个很好的研究平台,在此平台上,研究者可以定义自己的文档相关性测度,以改进检索性能。这样,作为一个研究课题,信息检索技术拥有了较为完善实验平台与评价指标,其研究理所当然地步入了快车道。也正因为如此,在70年代到80年代,许多信息检索的理论与模型被提出,并且被证明对当时所能获得的数据集是有效的。其中最为着名的是Gerard Salton提出的向量空间模型 。至今该模型还是信息检索领域最为常用的模型之一。但是,检索的对象——文本集合的缺乏使得这些技术在海量文本上的可靠性无法得到验证。当时的研究大多针对数千篇的文档组成的集合。这时,美国国家标准技术研究所(NIST)组织的文本检索会议(Text Retrieval Conference, TREC)的召开改变了这一情况。TREC是一个评测性质的会议,为参评者提供了大规模的文本语料,从而大大推动了信息检索技术的快速发展。会议的第一次召开是1992年,不久后,互联网兴起为信息检索技术提供了一个巨大的实验场。从Yahoo到Google,大量实用的文本信息检索系统开始出现并得到广泛应用。这些系统从事实上改变了人类获取信息与知识的方式。
目前,在文本检索领域,简单的信息检索已经开始向更加复杂且人性化的垂直搜索演化,引入了信息抽取技术以提取文档中的结构化信息。
模型
早期的信息检索系统采用“布尔查询”的方法来进行全文检索。这种方法无疑将构造一个合适的查询的责任推到用户身上。用户必须详细的规划自己的查询,其复杂程度不亚于编程语言。这种检索方式并不提供任何的文档相关性测度,对于文档与查询的评价就只有“匹配”,“不匹配”两种而已。这两点问题决定了布尔查询不能被广泛应用。但是,由于布尔检索能够给用户提供更多的可控制性,今天我们仍然可以在搜索引擎的“高级搜索”中找到布尔查询的身影。
对于大规模的语料库,任何检索都可能返回数量众多的结果,因此对检索结果进行排序是必须的。因此,一个好的信息检索模型必须提供文档相关性测度。一个好的测度应该使与用户查询需求最相关的那些结果,排在最前面,同时允许尽可能多的,与用户查询有一定关系的结果被包括进来。目前,最为常用的信息检索模型有三种:
向量空间模型 (Vector Space Model, VSM)
概率模型 (Probabilistic Model)
推理网络模型 (Inference Network Model)
向量空间模型
向量空间模型最早由Gerard提出。在此模型中,一个文档(Document)被描述成由一系列关键词(Term)组成的向量。模型并没有规定关键词如何定义,但是一般来说,关键词可以是字,词或者短语。在语音文档检索中,还可以是混淆类、音子、音子串等等单元。假设我们用“词”作为Term,那么在词典中的每一个词,都定义向量空间中的一维。如果一篇文档包含这个词,那么表示这个文档的向量在这个词所定义的维度上应该拥有一个非0值(对绝大多数系统来说,是正值)。
当一个查询被提交时,由于这个查询也是由文本构成,所以也可以被向量空间所表示。模型将对查询与文档,计算一个相似度需要注意的是,模型也没有对相似度给出确切的定义。它可以使欧氏距离,也可以是两个向量的夹角的余弦。
假设
D
→
{\displaystyle {\overrightarrow {D}}}
表示文档向量,而
Q
→
{\displaystyle {\overrightarrow {Q}}}
表示查询向量,文档与查询的相关性可以用余弦距离表示如下:
S
i
m
(
D
→
,
Q
→
)
=
D
→
⋅
Q
→
(
D
→
⋅
D
→
)
(
Q
→
⋅
Q
→
)
{\displaystyle Sim({\overrightarrow {D}},{\overrightarrow {Q}})={\frac {{\overrightarrow {D}}\cdot {\overrightarrow {Q}}}{({\overrightarrow {D}}\cdot {\overrightarrow {D}})({\overrightarrow {Q}}\cdot {\overrightarrow {Q}})}}}
如果我们用
w
t
i
Q
{\displaystyle w_{t_{i}Q}}
和
w
t
i
D
{\displaystyle w_{t_{i}D}}
表示
D
→
{\displaystyle {\overrightarrow {D}}}
和
Q
→
{\displaystyle {\overrightarrow {Q}}}
中的第
i
{\displaystyle i}
维的值,并且对每个文档矢量进行归一化,即令
D
→
⋅
D
→
≡
1
{\displaystyle {\overrightarrow {D}}\cdot {\overrightarrow {D}}\equiv 1}
,那么上式有可以表示为
S
i
m
(
D
→
,
Q
→
)
=
∑
t
i
∈
Q
∩
D
w
t
i
Q
⋅
w
t
i
D
{\displaystyle Sim({\overrightarrow {D}},{\overrightarrow {Q}})=\sum _{t_{i}\in Q\cap D}w_{t_{i}Q}\cdot w_{t_{i}D}}
在此,
w
t
i
{\displaystyle w_{t_{i}}}
究竟如何取值是一个重要的问题,其取值一般被称为关键词
i
{\displaystyle i}
在文档D中的权重。关键词权重问题将在随后进行专门的讨论。
传统向量空间模型的一个问题是各个维度间缺乏相关性,因而无法对文档中各个词的相关性提供信息。从宏观上看,仍然没有摆脱“关键词匹配”的窠臼。一个自然的想法就是对文档特征——文档向量进行降维,将维数巨大的文档向量投影到某个较小维度的空间中,使得关键词之间即使不完全匹配,也能够根据语义发生关系。这就诞生了潜语义索引(Latent Semantic Indexing),它通过对向量空间进行奇异值分解,将高维文档向量投射到低维潜语义空间中。潜语义索引随后被融入概率模型框架中,形成了基于概率模型的PLSI(Probabilistic Latent Semantic Indexing),
和LDA(Latent Dirichlet Allocation)。
资料性质:开放百科知识资料,非即时新闻。原文:https://zh.wikipedia.org/w/index.php?curid=950499&oldid=69179004;原作者:维基百科贡献者(作者名单见原文历史记录)。本文按CC BY-SA 4.0转载与整理,许可:https://creativecommons.org/licenses/by-sa/4.0/。修改内容:繁体转简体、去除网页导航、按完整段落节选并整理排版;未声称原创。
图片:Edwardgao;Public domain;;来源:https://commons.wikimedia.org/wiki/File:IVDOC.png;按网页尺寸显示。
资料来源
- 维基百科贡献者;CC BY-SA 4.0;节选、繁转简与排版整理,正文保留原文及许可URL